Speech-to-Text
Gesprochene Sprache wird automatisch zu editierbarem Text, die Sprache erkennt der Hub selbst.

Funktionen
Alles in einer Oberfläche. Kein zweites Tool, kein zweiter Login.
01 — Transkription
Das Transkript ist nicht Beiwerk, sondern Navigation: im Text suchen, Passagen markieren, daraus Sequenzen bauen. Wer den Satz findet, hat den Schnitt.
02 — Mehrsprachigkeit
Untertitel und Übersetzungen entstehen aus derselben Quelle. Internationale Fassungen brauchen keinen zweiten Durchlauf und keine externe Tipparbeit.
03 — Übergabe
Der Rohschnitt verlässt SimplyHUB als AAF oder ALE, Marker und Timecodes inklusive. Die Feinarbeit passiert dort, wo Ihre Cutter zu Hause sind.
04 — Erkennung
Gesicht, Stimme, Erscheinung und Drehort führen zur selben Person, über Folgen hinweg. Wiederkehrende Gesichter gruppiert der Hub selbst, benannt wird einmal.
Erkennung
Vier Merkmale werden getrennt gelernt und zusammen durchsucht.
Schnitt aus Daten
Ganze Folgen entstehen aus dem, was Erkennung und Transkription ohnehin erfasst haben.
Ihr Workflow
Am Schnittplatz
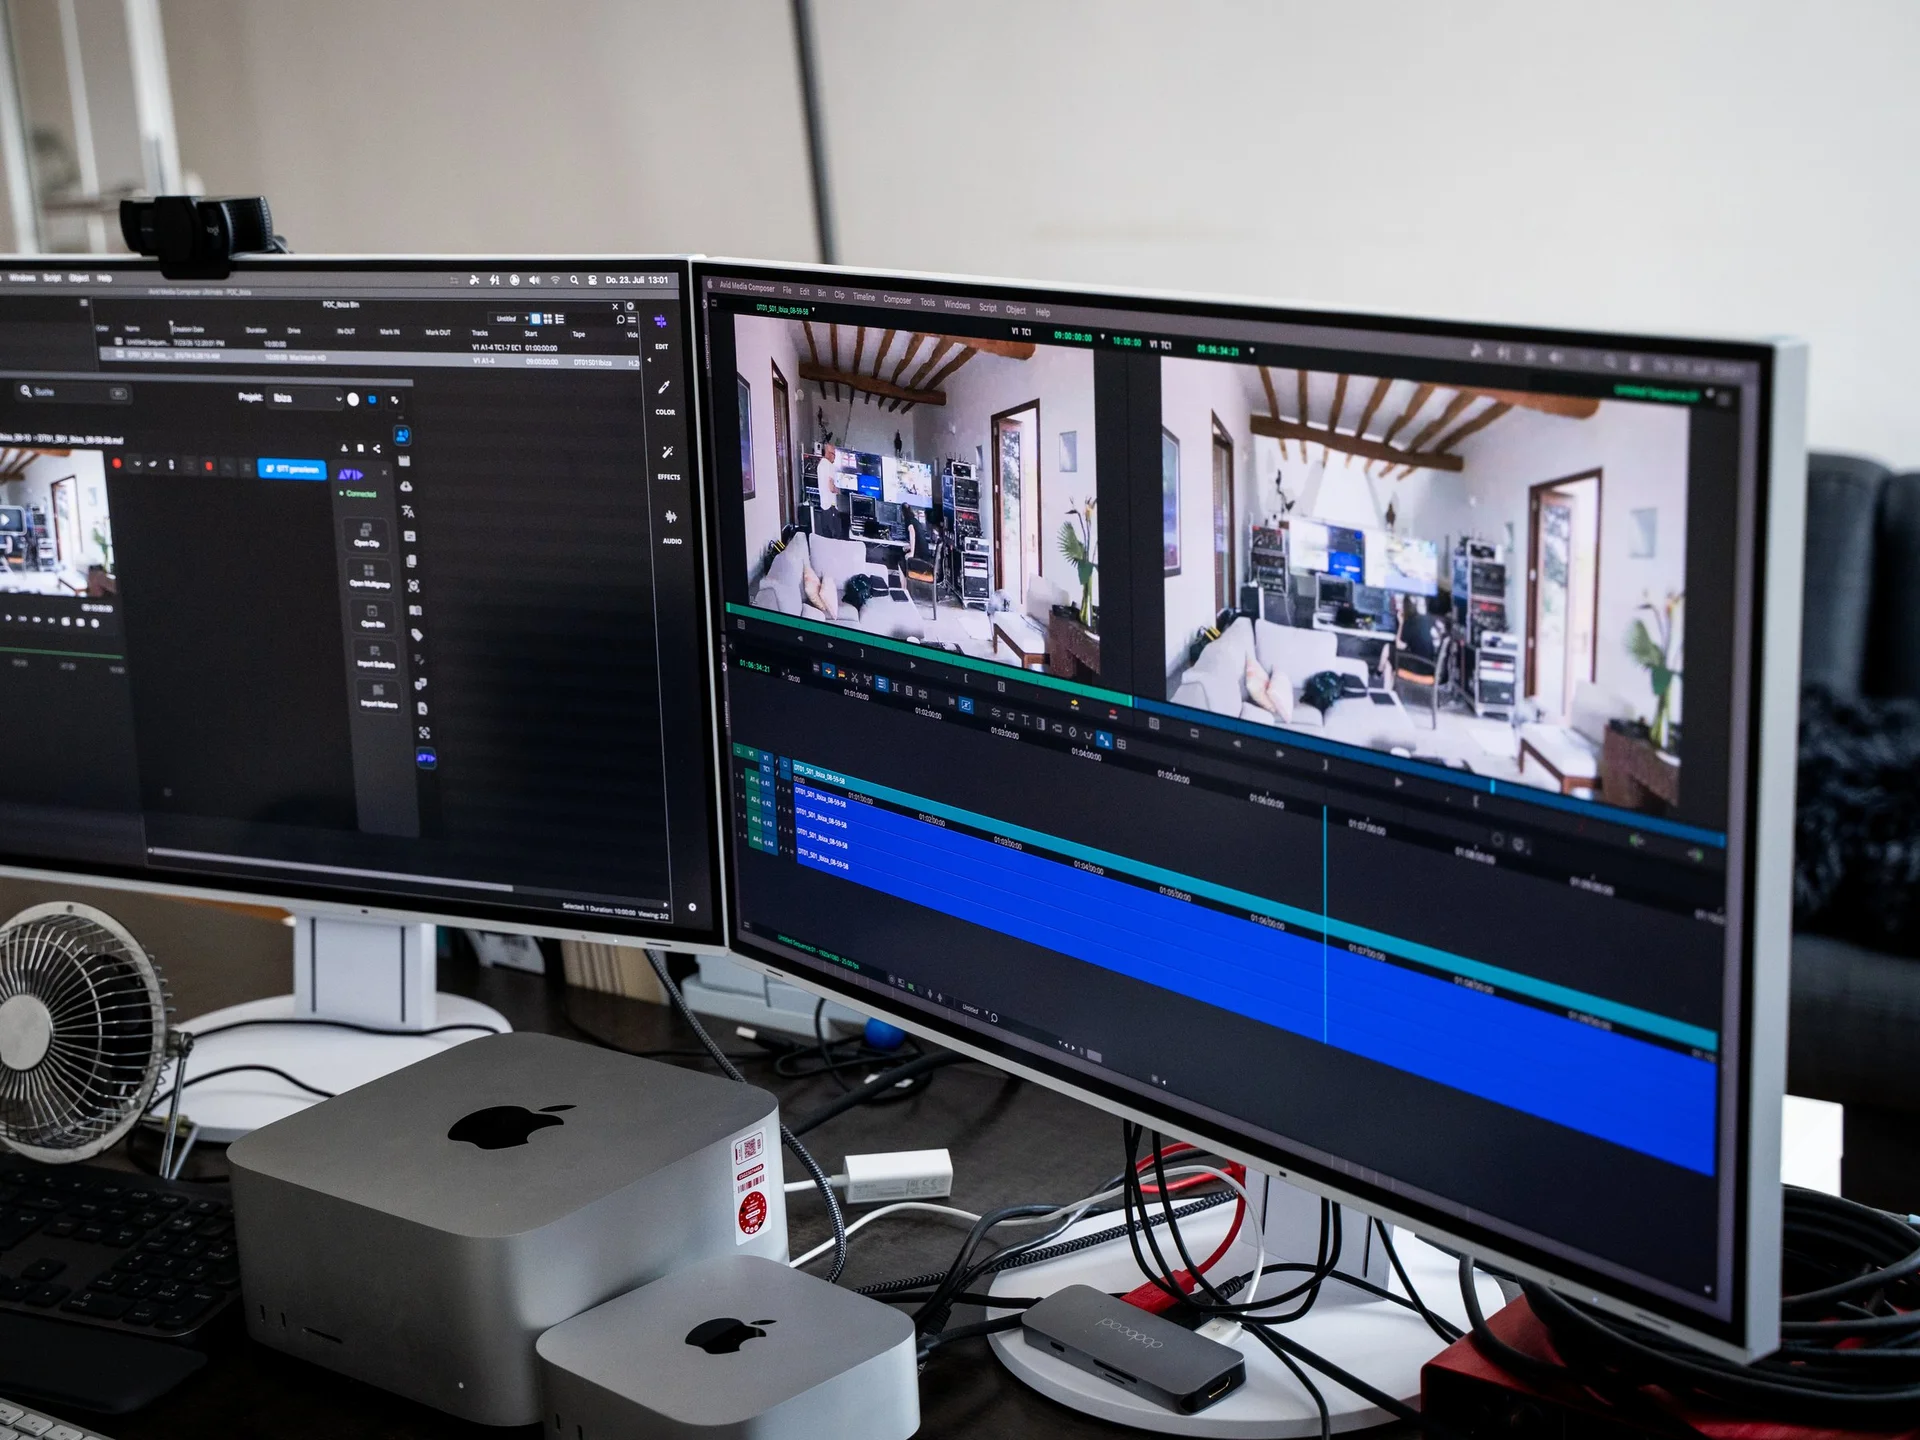
Kein Export, kein Download-Ordner. Der Clip öffnet sich dort, wo geschnitten wird.
Im Detail
Weitere Module
Jedes Modul läuft eigenständig. Zusammen teilen sie Medien, Rechte und Metadaten.